Published: June 27, 2025
0
13
93
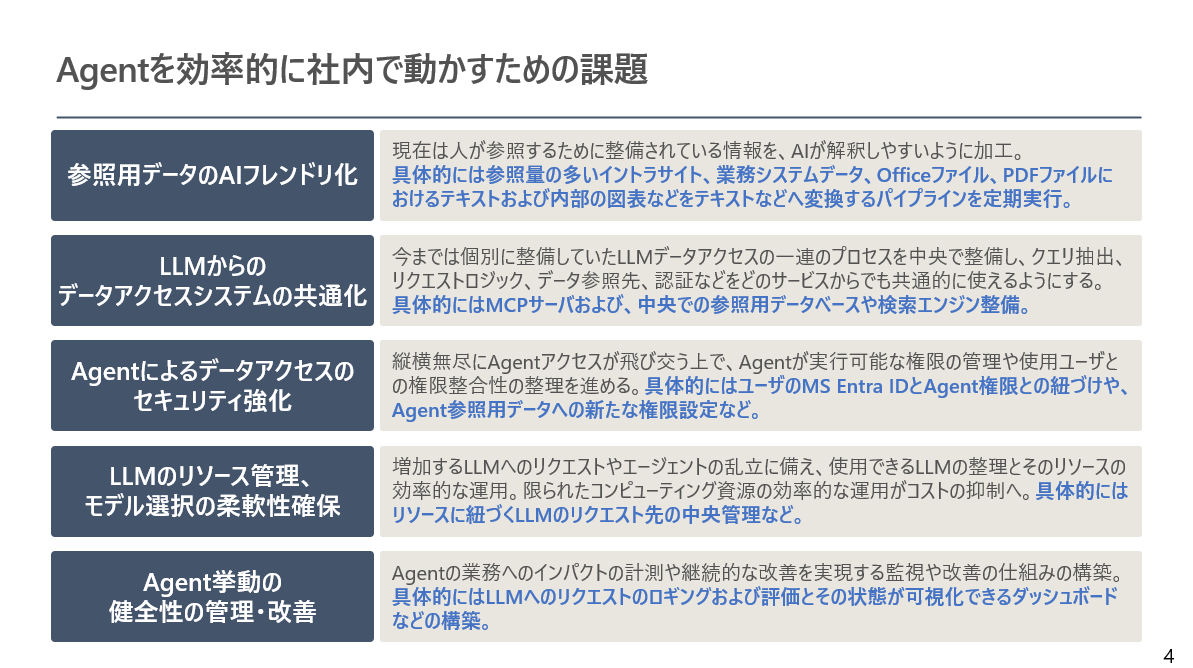
Coding,Researchエージェントに始まり、現在はSlide作成のAgentが発展中。Agentは徐々に我々の仕事領域を侵食している。本格的な開発者ではない私でさえ、1日のWeb検索回数、言い換えれば情報探索の作業の大部分は気づけばAIに主導権を渡している。 企業はこの事実を重く受け止めた方がいい。 データアクセスをする主体は間もなく人間からAgentにその座を譲ることになる。 自社のデータの多くは人間が見るために作られている。 アクセスのほとんどがAIに変わったらどうする? 人間の何倍ものスピードでアクセスが走るその全てが、質の悪い情報解釈となる。 AIが解釈しやすいデータ参照の仕組みの整備が必要だが、この整備はすぐに終わるものではない。 対処が遅れると、企業の生産性に多大な影響を及ぼすことになるだろう。 これだけではない。 データソースに合ったクエリの作り方は? プロジェクトや部署ごとにデータアクセスの仕組みを作り込みが発生しないか? 莫大なトークン消費にリソースは足りるのか? アクセスが不透明になっていないか? AgentはどこまでDataに触っていい? そもそもAgentはちゃんと健全に動けているのか? これらの課題に追従できるだろうか。 時代は動き始めている。