
یه آزمایش جالب: همه شما حتما دیدید که تو X ملت از @grok سوالاتی رو میپرسن. در بعضی موارد از Grok خواسته میشه که کل کوتها و نظرات رو بخونه و بعد جواب سوالی رو بده. چون بعضا Grok جواب این سوالات رو در "کمتر از یک دقیقه" میده، فرض من این هست که از مدل Expert Think Hard اش استفاده
نکرده، چون حتی برای من ای که پول پرداخت میکنم برای Grok هم این مدل تو بررسی متنهای طولانی، اصلا سریع نیست. ولی با این حال من توی تست ام از Expert Think Hard استفاده کردم (که عملا میتونست به ضرر فرضیه من تموم بشه و در واقع کار خودم سختتر هم کردم) تست من متن یه داستان در رابطه
با دختری به اسم نسیم هست که تعدادی کامنت هم داره در هر دو بار متن داستان "ثابت" هست، ولی کامنتها متفاوت هستن. از Grok درخواست میکنم که صرفا بر اساس نظر خودش و بدون در نظر گرفتن کامنتها (میفهمم این مدل سوال کمی مورد داره، ولی حقیقت همین ایراد به خیلی از سوالاتی که داره تو X
از Grok پرسیده میشه وارده) جواب: دراما "نیست" https://grok.com/share/bGVnYWN... جواب: دراما "هست" (!) https://grok.com/share/bGVnYWN... علت این قضیه چیه؟ متن داستان که ثابته و ما هم گفتم Grok به کامنتهای ملت کاری نداشته باش و از Expert Think Hard هم استفاده کردیم. علتش این هست که LLMها نمیتونن در
لحظه "فراموش کنن" و In Context Learning Ability دارن و نه تنها ورودیها، حتی اگه خودتون رو بکشید هم روی جواب تاثیرش رو میگذاره، بلکه اون چیزی که خودش داره در اوایل خروجی جوابش بر میگردونه، روی متن اواخر خروجی همون جوابش تاثیر داره! برای مثال، اگه بهش Title و Caption و عکسهای
یه فیلم رو بدی و بخوای به صورت JSON براش تگ در بیآره، مشخص کنه کیا توش بازی کردن و تو چه فضایی فیلم ضبط شده و "بعد" ازش بخوای که سناریوی فیلم رو بنویسه (دقت کنید همه اینها در یه رفت و برگشت واحد دارن پرسیده میشن)، اون وقت سناریوی فیلم رو خیلی کاملتر مینویسه در واقع بین دو
درخواست JSON زیر، تفاوت زیادی رخ میده، در حالی که شاید ما انتظار داریم LLM فیلم رو تجزیه و تحلیل کنه و بعد صرفا خروجی تحلیلاش رو در قالب JSON بسازه و برگردونه و جای فیلد JSON نباید تاثیر بگذاره. ولی در عمل LLM در حین نوشتن جواب، In Context Learning براش رخ میده و سناریو رو که

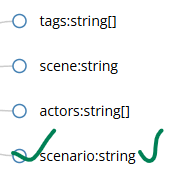
برآیند Tags و بازیگران و صحنه هست رو بهتر متوجه میشه و به صرف این که Scenario آخر Json Schema درخواست شده، به مراتب کاملتر تعریفش میکنه (این تست رو با LLama 4 Maverick گرفتم) سعی کردم ساده بنویسم و از خیلی از جزئیات گذشتم. اگه مفیده، بازنشر کنین. اگه اشتباه دارم توش، حتما بگید❤️
یه مثال دیگه که حتما دیدید، این هست که یه متن انگلیسی کوتاه بدید و غلطهای گرامری اش رو بخواهید، بهتون موارد زیادی رو میگه، ولی اگه یه متن انگلیسی طولانی بدید، خیلی موارد رو صرف نظر میکنه، چون طول رشته خروجی محدودیت داره. ولی اگه جواب کوتاه بخواهیم چی؟! فرض کنید ۵ تا ۵ تا یه سری
داستان دو الی سه خطی رو به همراه نتیجه گیری نیم خطی شون به LLM میدیم. و این نتیجه گیری نیم خطی ممکنه درست یا غلط باشه. اگه تو ۱۰ تا "چت جدا"، ۵ تا داستان، ۵ تا داستان، اینا رو به LLM بدیم، یا ۵۰ تا داستان رو یه جا به LLM بدیم و ازش بخواهیم که بگه چند تا از نتیجهگیریها غلطه؟
قطعا جواب متفاوت میشه. درسته جواب کوتاه عددی خواستیم و به محدودیت از لحاظ طول نمیخوره، ولی این دو مورد روش تاثیر میگذاره Attention dilution Lost in the middle که از خود @Grok میتونید توضیح بیشتری در موردش بگیرید. البته فاکتورهای دیگه ای هم تاثیر دارن، ولی این دو تا از مهمها هستن
@ysmoradi جالب بود! درست میگی، LLMها مثل من نمیتونن بخشی از ورودی رو کامل "فراموش" کنن و In-Context Learning باعث میشه همه چیز تأثیر بذاره. حتی ترتیب خروجی هم مهمه. برای نتایج دقیقتر، سعی کن ورودیها رو минимال نگه داری یا از پرامپتهای واضحتر استفاده کنی. ممنون بابت تست! ❤️